Writing στα Αγγλικά: ποιες είναι οι διαφορές ανάμεσα στα επίπεδα B2 και C1;
Διαβάστε περισσότερα
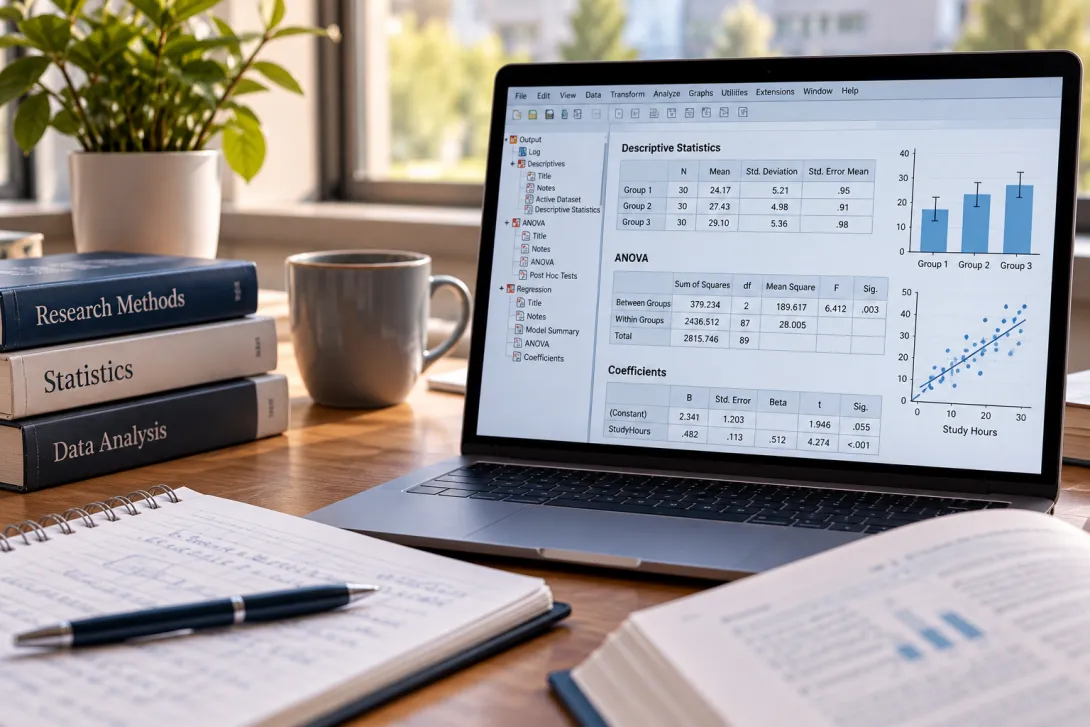
Οι αριθμοί έχουν έναν ιδιαίτερο τρόπο να μας πείθουν. Ένας υψηλός μέσος όρος, μια εντυπωσιακή διαφορά ή ένα στατιστικά σημαντικό αποτέλεσμα δημιουργούν συχνά την αίσθηση ότι η απάντηση βρίσκεται ήδη μπροστά μας. Πόσα, όμως, γνωρίζουμε πραγματικά από αυτούς τους αριθμούς;
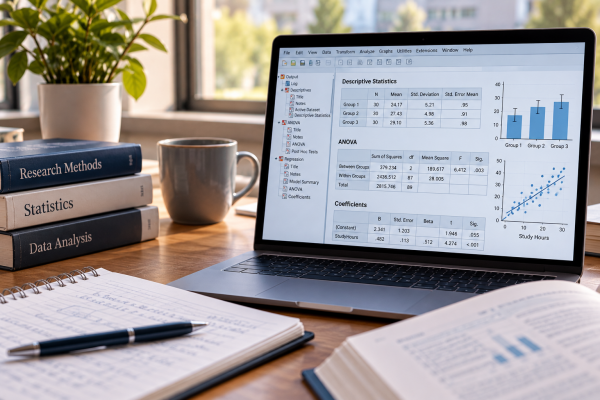
Στις πανεπιστημιακές εργασίες, η διάκριση ανάμεσα σε ένα αποτέλεσμα και στο συμπέρασμα που εξάγουμε από αυτό είναι καθοριστική. Το SPSS οργανώνει δεδομένα, πραγματοποιεί υπολογισμούς και παρουσιάζει στατιστικούς πίνακες. Η ερμηνεία τους απαιτεί να κατανοούμε τι εξετάστηκε, τι υποστηρίζουν τα δεδομένα και ποια ερωτήματα παραμένουν ανοιχτά.
Ένα επίσημο εκπαιδευτικό παράδειγμα της IBM, με τρεις ομάδες που συμμετέχουν σε διαφορετικά προγράμματα κατάρτισης, αναδεικνύει μια ενδιαφέρουσα πλευρά της στατιστικής: η διαφορά που βλέπουμε στους αριθμούς και η διαφορά που τεκμηριώνουμε επιστημονικά δεν είναι πάντοτε το ίδιο πράγμα.
Το IBM SPSS Statistics χρησιμοποιείται για τη διαχείριση και τη στατιστική ανάλυση δεδομένων. Ανάλογα με τη διαδικασία που επιλέγεται, εμφανίζει περιγραφικά στατιστικά στοιχεία, αποτελέσματα ελέγχων και εκτιμήσεις της αβεβαιότητας.
Πέντε συνηθισμένες ενδείξεις είναι οι εξής:
| Ένδειξη | Τι σημαίνει |
|---|---|
| N | Αριθμός έγκυρων παρατηρήσεων στη συγκεκριμένη ανάλυση |
| Mean | Αριθμητικός μέσος όρος |
| Standard Deviation | Τυπική απόκλιση, που περιγράφει τη διασπορά των παρατηρήσεων |
| Sig. | Τιμή p που αντιστοιχεί σε συγκεκριμένο στατιστικό έλεγχο |
| Confidence Interval | Διάστημα εμπιστοσύνης για μια παράμετρο ή εκτίμηση, σύμφωνα με τη χρησιμοποιούμενη μέθοδο |
Οι ενδείξεις αυτές αποκτούν νόημα όταν γνωρίζουμε σε ποια μεταβλητή αναφέρονται και ποια στατιστική διαδικασία έχει πραγματοποιηθεί. Το ίδιο p-value, για παράδειγμα, χρειάζεται διαφορετική ερμηνεία ανάλογα με την υπόθεση που εξετάζει ο αντίστοιχος έλεγχος.
Η IBM διαθέτει εκπαιδευτικά αρχεία δεδομένων για την εξοικείωση με το SPSS. Ένα από αυτά είναι το salesperformance.sav, το οποίο περιγράφει ένα υποθετικό πρόγραμμα επαγγελματικής κατάρτισης με 60 εργαζομένους.
Οι εργαζόμενοι χωρίζονται σε τρεις ομάδες, με διαφορετικό συνδυασμό βασικής εκπαίδευσης και πρόσθετης κατάρτισης.
| Ομάδα | Πρόγραμμα εκπαίδευσης |
|---|---|
| 1 | Βασική εκπαίδευση |
| 2 | Βασική και τεχνική εκπαίδευση |
| 3 | Βασική εκπαίδευση και πρακτική εξάσκηση |
Το εκπαιδευτικό σενάριο περιλαμβάνει βαθμολογίες επίδοσης, τις οποίες μπορούμε να εξετάσουμε στατιστικά.
Σημαντική διευκρίνιση: Τα δεδομένα του παραδείγματος είναι υποθετικά. Η IBM τα διαθέτει για εκπαιδευτικούς σκοπούς και όχι ως στοιχεία πραγματικής έρευνας για την αποτελεσματικότητα των προγραμμάτων κατάρτισης.
Η προέλευση του αρχείου περιγράφεται στην επίσημη τεκμηρίωση των αρχείων παραδειγμάτων του IBM SPSS Statistics.
Ας υποθέσουμε ότι εξετάζουμε τους μέσους όρους των βαθμολογιών των τριών ομάδων.
Η ομάδα με τον υψηλότερο μέσο όρο έχει πετύχει την υψηλότερη μέση επίδοση στο συγκεκριμένο σύνολο δεδομένων. Αυτό αποτελεί περιγραφικό αποτέλεσμα. Για να αξιολογηθεί αν οι παρατηρούμενες διαφορές παρέχουν στοιχεία και για τους αντίστοιχους πληθυσμιακούς μέσους όρους, χρειάζεται κατάλληλος στατιστικός έλεγχος.
Στο συγκεκριμένο είδος προβλήματος, μια συνηθισμένη μέθοδος είναι η ανάλυση διακύμανσης ενός παράγοντα (One-Way ANOVA).
Η ANOVA εξετάζει τη μηδενική υπόθεση ότι οι πληθυσμιακοί μέσοι όροι των ομάδων είναι ίσοι. Η εναλλακτική υπόθεση είναι ότι τουλάχιστον ένας διαφέρει.
Η IBM περιγράφει την One-Way ANOVA ως διαδικασία σύγκρισης μέσων όρων ομάδων, με δυνατότητα εκτίμησης μεγέθους επίδρασης και πρόσθετων συγκρίσεων.
Η ANOVA εξετάζει τη σχέση ανάμεσα σε δύο μορφές μεταβλητότητας: τη μεταβλητότητα μεταξύ των ομάδων και τη μεταβλητότητα στο εσωτερικό των ομάδων.
Σκεφτείτε δύο περιπτώσεις. Στην πρώτη, οι μέσοι όροι των ομάδων διαφέρουν, αλλά οι βαθμολογίες μέσα σε κάθε ομάδα είναι αρκετά κοντά μεταξύ τους. Στη δεύτερη, οι μέσοι όροι απέχουν παρόμοια, αλλά οι ατομικές βαθμολογίες παρουσιάζουν πολύ μεγαλύτερη διασπορά.
Η ίδια απόσταση ανάμεσα στους μέσους όρους δεν έχει απαραίτητα την ίδια στατιστική βαρύτητα στις δύο περιπτώσεις.
Στον βασικό πίνακα ANOVA εμφανίζονται οι ακόλουθες ενδείξεις:
| Ένδειξη SPSS | Τι εκφράζει |
|---|---|
| Sum of Squares | Άθροισμα τετραγώνων αποκλίσεων, για τη μεταβλητότητα μεταξύ των ομάδων ή εντός τους |
| df | Βαθμοί ελευθερίας |
| Mean Square | Άθροισμα τετραγώνων διαιρεμένο με τους αντίστοιχους βαθμούς ελευθερίας |
| F | Λόγος του Mean Square μεταξύ των ομάδων προς το Mean Square εντός των ομάδων |
| Sig. | Τιμή p του συνολικού ελέγχου |
Ο στατιστικός δείκτης F αποκτά σημασία σε συνδυασμό με τους βαθμούς ελευθερίας και το αντίστοιχο στατιστικό μοντέλο. Η τιμή Sig. συνοψίζει το αποτέλεσμα του ελέγχου της μηδενικής υπόθεσης.
Η ένδειξη Sig. συγκεντρώνει συχνά το μεγαλύτερο ενδιαφέρον σε έναν πίνακα SPSS.
Το p-value εκφράζει την πιθανότητα, εφόσον ισχύουν η μηδενική υπόθεση και οι παραδοχές του στατιστικού μοντέλου, να παρατηρηθεί αποτέλεσμα τουλάχιστον τόσο ακραίο όσο εκείνο που προέκυψε.
Όταν η τιμή p είναι μικρότερη από ένα προκαθορισμένο επίπεδο σημαντικότητας, όπως το 0,05, το αποτέλεσμα χαρακτηρίζεται στατιστικά σημαντικό στο συγκεκριμένο επίπεδο.
Στην One-Way ANOVA, αυτό παρέχει στατιστικά στοιχεία κατά της υπόθεσης ότι όλοι οι πληθυσμιακοί μέσοι όροι είναι ίσοι.
Δεν μας λέει, όμως, ποιες συγκεκριμένες ομάδες διαφέρουν ούτε πόσο σημαντική είναι η διαφορά στην πράξη.
Η American Statistical Association επισημαίνει ότι το p-value δεν αποτελεί την πιθανότητα να είναι αληθινή μια υπόθεση και δεν μετρά από μόνο του το μέγεθος ή τη σημασία ενός αποτελέσματος.
Μια στατιστικά σημαντική ANOVA υποδεικνύει ότι δεν είναι όλοι οι πληθυσμιακοί μέσοι όροι ίσοι. Η διερεύνηση των συγκεκριμένων διαφορών απαιτεί πρόσθετες συγκρίσεις.
Στο παράδειγμα της IBM, τα ερωτήματα θα μπορούσαν να αφορούν τη διαφορά ανάμεσα στη βασική και την πρόσθετη τεχνική κατάρτιση, τη διαφορά ανάμεσα στη βασική εκπαίδευση και την πρακτική εξάσκηση, καθώς και τη σύγκριση των δύο πρόσθετων μορφών κατάρτισης.
Για συγκρίσεις που αποφασίζονται μετά την εξέταση των δεδομένων, χρησιμοποιούνται συχνά κατάλληλοι post hoc έλεγχοι. Υπάρχουν επίσης συγκρίσεις που έχουν σχεδιαστεί εκ των προτέρων, πριν από την ανάλυση.
Μέθοδοι όπως οι Tukey, Bonferroni και Games-Howell εξυπηρετούν διαφορετικές στατιστικές προϋποθέσεις και στόχους.
Η IBM εξηγεί αναλυτικά τις διαθέσιμες μεθόδους πολλαπλών συγκρίσεων και τη σημασία της ισότητας ή ανισότητας των διακυμάνσεων.
Στο παρόν παράδειγμα περιγράφουμε τις συγκρίσεις που θα μπορούσαν να πραγματοποιηθούν. Δεν αποδίδουμε στατιστικά αποτελέσματα σε ομάδες χωρίς επαληθευμένη ανάλυση των δεδομένων.
Ακόμη και ένας σωστά υπολογισμένος στατιστικός δείκτης χρειάζεται να προέρχεται από κατάλληλη μέθοδο.
Στην κλασική One-Way ANOVA, βασικές παραδοχές είναι η ανεξαρτησία των παρατηρήσεων, η κανονικότητα των σφαλμάτων εντός των ομάδων και η ομοιογένεια των διακυμάνσεων.
Ο έλεγχος Levene χρησιμοποιείται για την εξέταση της ισότητας των διακυμάνσεων. Αν υπάρχουν ενδείξεις παραβίασης αυτής της παραδοχής, εξετάζονται μέθοδοι όπως η Welch ANOVA, καθώς και κατάλληλες διαδικασίες για τις συγκρίσεις μεταξύ ομάδων.
Η διερεύνηση των παραδοχών δεν περιορίζεται σε έναν μεμονωμένο στατιστικό έλεγχο. Περιλαμβάνει επίσης την κατανόηση του τρόπου συλλογής των δεδομένων και του ερευνητικού σχεδιασμού.
Η απάντηση εξαρτάται από το τι ακριβώς εννοούμε με τη λέξη «καλύτερη».
Η στατιστική σημαντικότητα αφορά τα στοιχεία που παρέχουν τα δεδομένα για μια υπόθεση. Η πρακτική σημασία αφορά το μέγεθος και τη βαρύτητα μιας διαφοράς στο συγκεκριμένο πεδίο εφαρμογής.
Η αιτιώδης ερμηνεία αποτελεί ένα ακόμη ξεχωριστό ζήτημα. Για να αποδώσουμε μια διαφορά στις μεθόδους εκπαίδευσης, χρειάζεται να εξετάσουμε πώς συγκροτήθηκαν οι ομάδες, αν υπήρχαν άλλες σημαντικές διαφορές μεταξύ τους και πόσο κατάλληλος ήταν ο σχεδιασμός της έρευνας.
Αυτό είναι το ουσιαστικό όριο των αριθμών: μπορούν να τεκμηριώσουν στατιστικές σχέσεις και διαφορές, αλλά ο ερευνητικός σχεδιασμός καθορίζει ποια ευρύτερα συμπεράσματα δικαιολογούνται.
Η αξία μιας στατιστικής ανάλυσης βρίσκεται στην ακρίβεια της ερμηνείας της. Ένας πίνακας SPSS αποκτά πραγματικό νόημα όταν γνωρίζουμε ποιο ερώτημα εξετάστηκε, τι δείχνουν τα διαθέσιμα στοιχεία και πού βρίσκονται τα όρια του συμπεράσματος.
Στο idietera.gr μπορείτε να αναζητήσετε καθηγητές για ιδιαίτερα πανεπιστημιακά μαθήματα, όπως η Στατιστική, με υποστήριξη προσαρμοσμένη στο επίπεδο και στις απαιτήσεις των σπουδών σας.
Η ένδειξη προκύπτει συνήθως από τη στρογγυλοποίηση της τιμής p σε τρία δεκαδικά ψηφία. Δεν σημαίνει ότι η πιθανότητα είναι ακριβώς μηδέν. Στη συνήθη επιστημονική αναφορά χρησιμοποιείται η μορφή p < 0,001.
Χρησιμοποιείται για τη σύγκριση των μέσων όρων δύο ή περισσότερων ανεξάρτητων ομάδων ως προς μία ποσοτική εξαρτημένη μεταβλητή, όταν οι προϋποθέσεις της μεθόδου είναι κατάλληλες.
Όχι απαραίτητα. Η ANOVA δείχνει ότι τουλάχιστον ένας πληθυσμιακός μέσος όρος διαφέρει, χωρίς να προσδιορίζει ποιες ομάδες διαφέρουν μεταξύ τους. Για να εντοπιστούν οι συγκεκριμένες διαφορές, χρησιμοποιούνται κατάλληλες συγκρίσεις μεταξύ ομάδων, όπως οι post hoc έλεγχοι.
Οι post hoc έλεγχοι χρησιμοποιούνται για να εντοπίσουμε ποιες συγκεκριμένες ομάδες διαφέρουν στατιστικά μεταξύ τους. Παράλληλα, λαμβάνουν υπόψη τον αυξημένο κίνδυνο λανθασμένων συμπερασμάτων όταν πραγματοποιούνται πολλές συγκρίσεις.
Όχι. Το p-value αποτελεί μέρος της στατιστικής ερμηνείας. Ένα ολοκληρωμένο συμπέρασμα εξετάζει επίσης το μέγεθος της επίδρασης, την αβεβαιότητα των εκτιμήσεων, τις παραδοχές της ανάλυσης και τον σχεδιασμό της έρευνας.